Appearance
主流AI卡架构
写在前面
准备开个新坑,学习一下当前主流AI计算卡的架构。
在进行这篇笔记的过程中,阅读到了deepseek大佬刘胜与的《我不得不把才华埋葬在昨天》,这篇文章是一定程度上的破圈了,即使是身处AI最中心的开发者,也会因为AI的日新月异而思考转型的问题。只需要给AI提供如硬件架构,语法规范之类的信息,AI自己就能针对算子进行迭代优化。而人力要完成这个工作,学习硬件架构,编程规范,调优工具每一个都要消耗大量的时间。
NVIDIA GPU架构
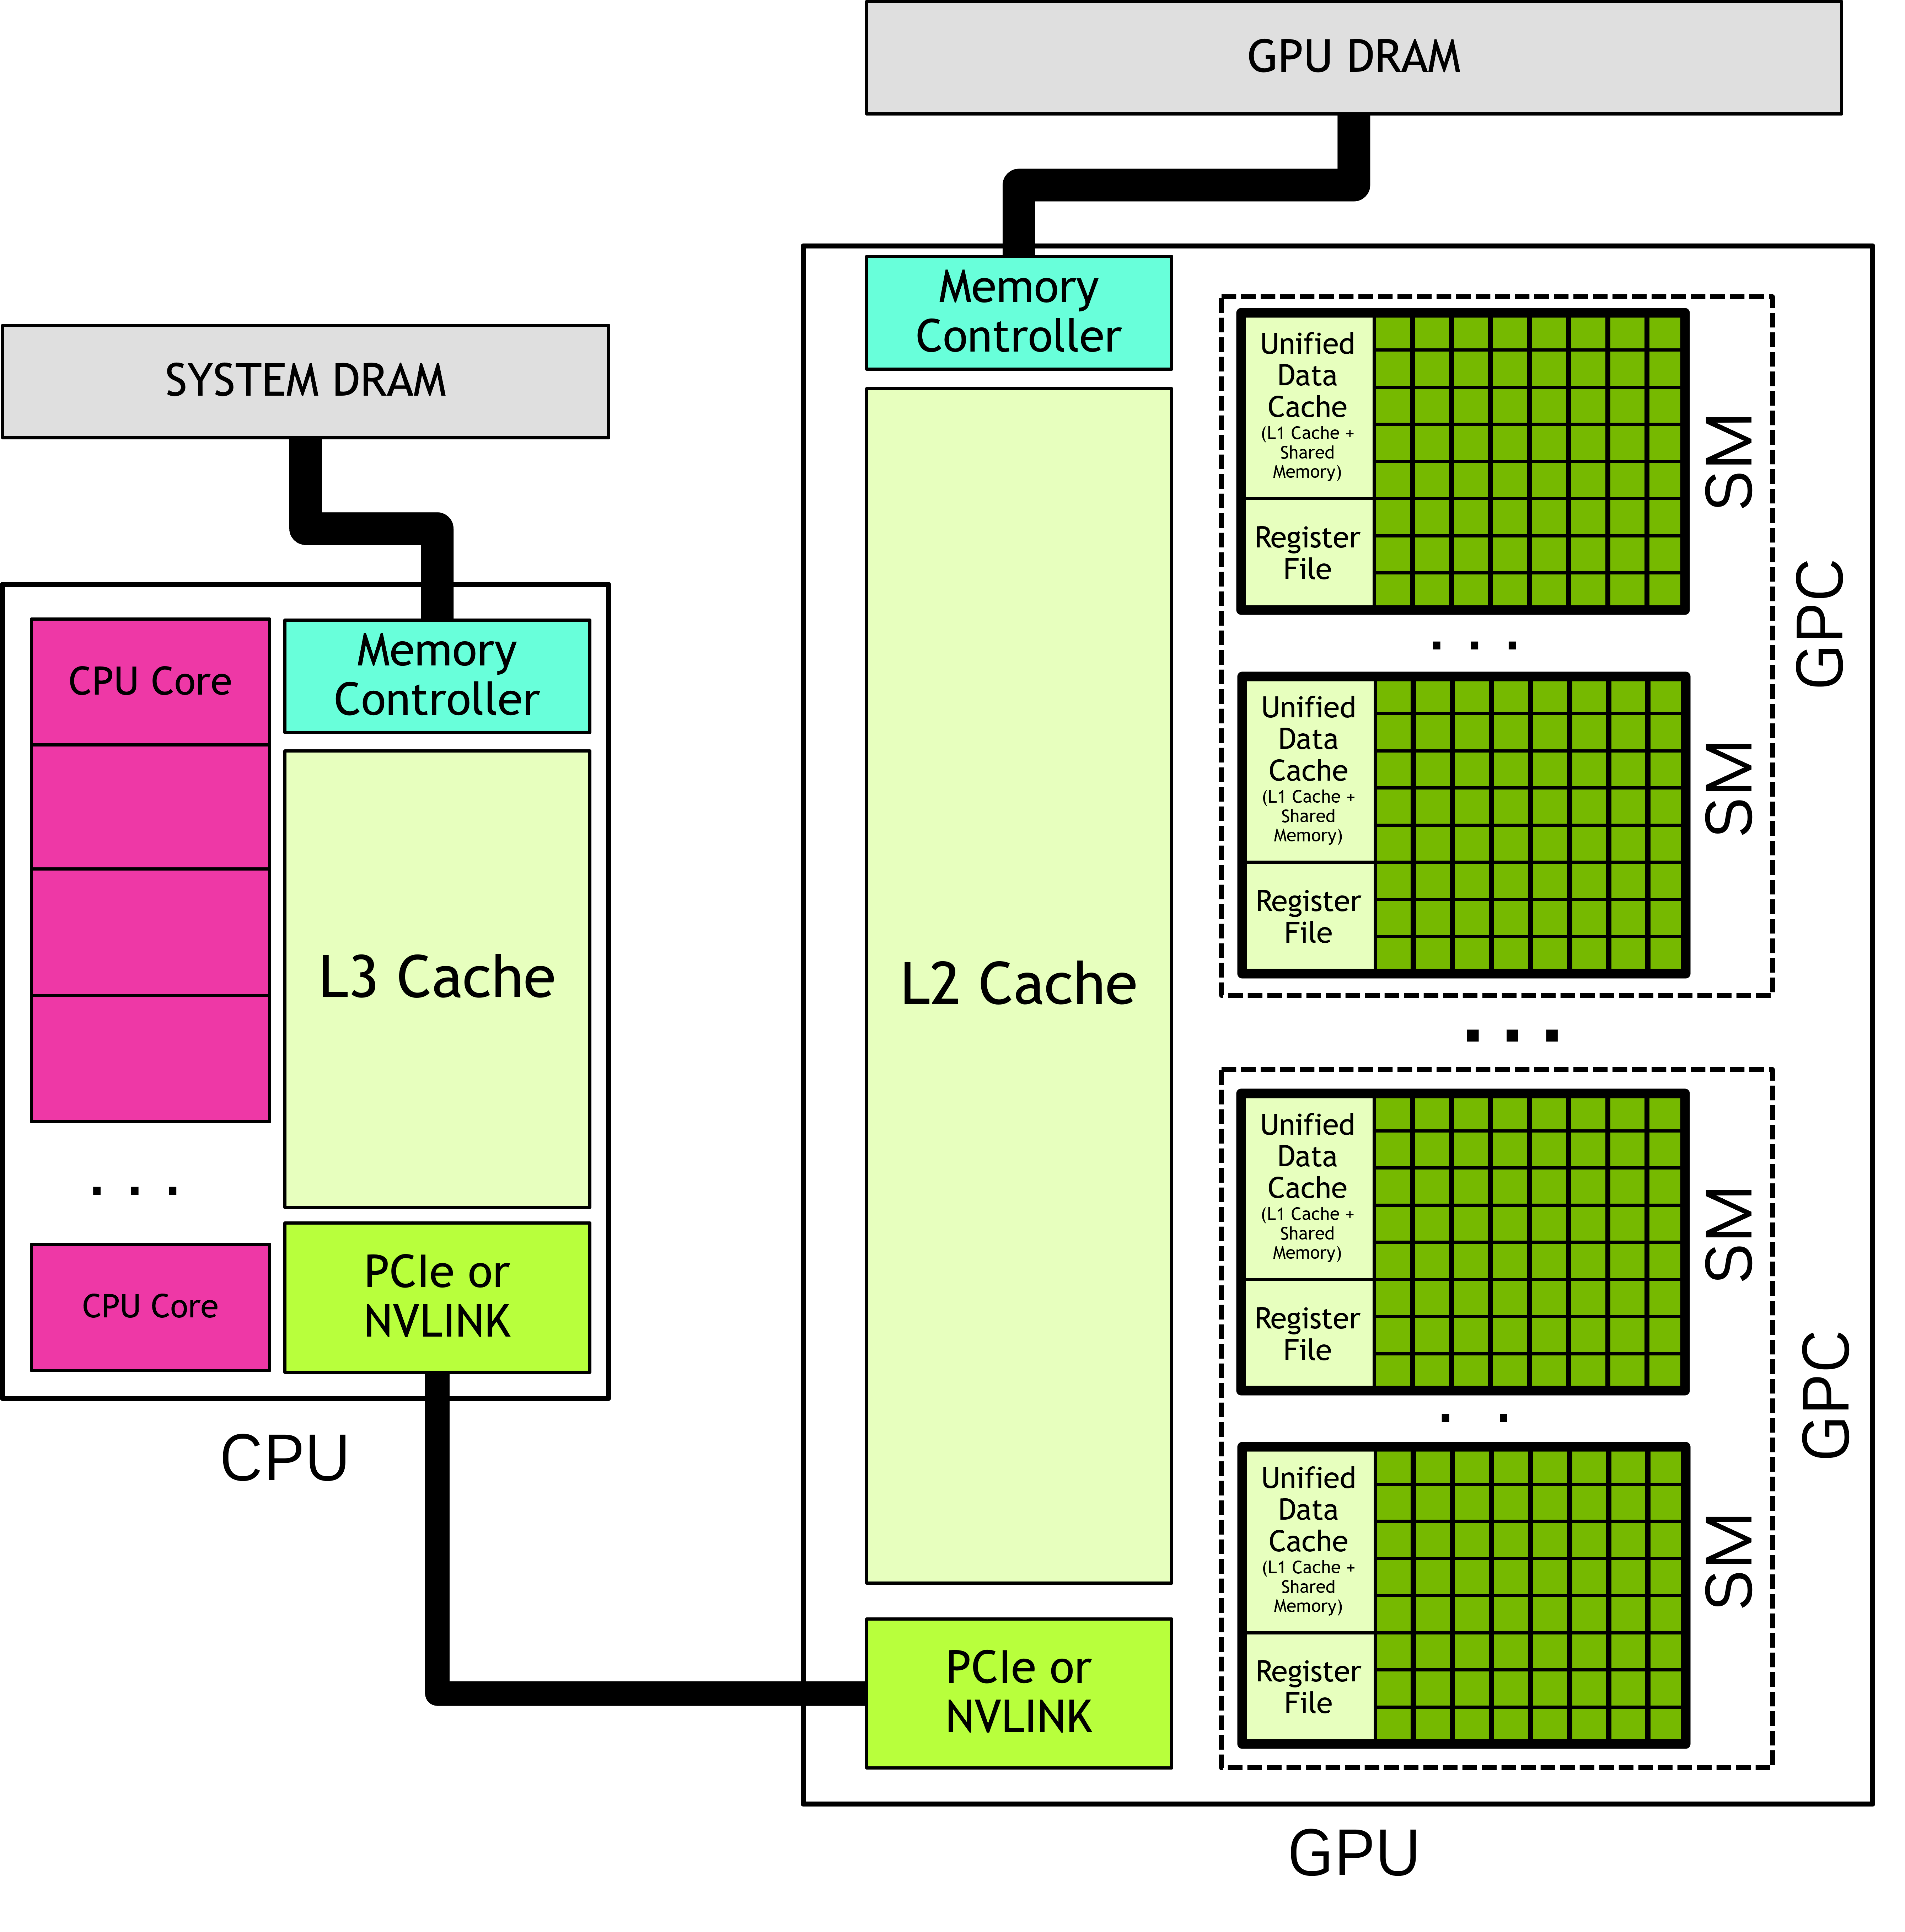
学习GPU架构,NVIDIA 肯定是绕不开的。硬件层次上,简单的划分就是GPU->GPCs->SMs,这样的包含关系,但是实际上更关注SM。可以认为SM是GPU的基本计算单元,每个SM都有自己的寄存器文件、共享内存、L1缓存、L2缓存等。
CUDA编程模型和SM的设计密切相关。CUDA程序中:
cpp
__global__ void kernel(int *a, int *b, int *c) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;
    c[tid] = a[tid] + b[tid];
}

int main(){
    int *a, *b, *c;
    int size = 1024;
    cudaMalloc((void**)&a, size * sizeof(int));
    cudaMalloc((void**)&b, size * sizeof(int));
    cudaMalloc((void**)&c, size * sizeof(int));
    // kernel<<<blockPerGrid, threadPerBlock>>>(args);
    kernel<<<1, size>>>(a, b, c);
    cudaFree(a);
    cudaFree(b);
    cudaFree(c);
    return 0;
}
开发者能控制的就是blockPerGrid和threadPerBlock,这两个参数确定了CUDA程序在GPU上的并行度。threadPerBlock最大为1024,以32个线程为一个warp,warp是SM进行计算的基本调度单位。
Ascend NPU
GPU的全程是Graphics Processing Unit,而NPU的全程是Neural Processing Unit。从名字上可以看出,GPU主要用于图形渲染,而NPU主要用于神经网络计算。
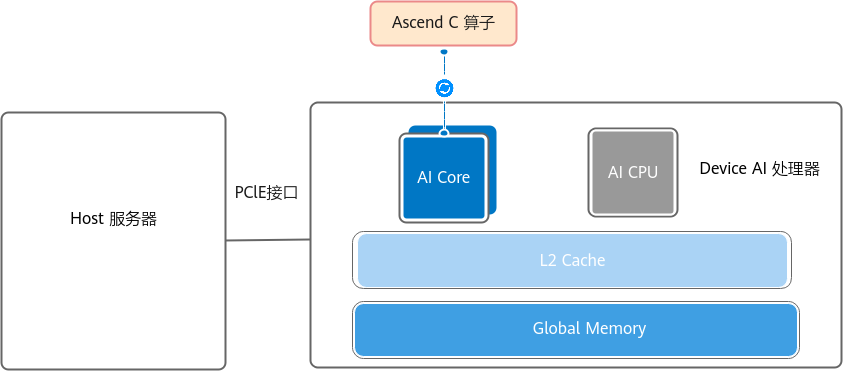
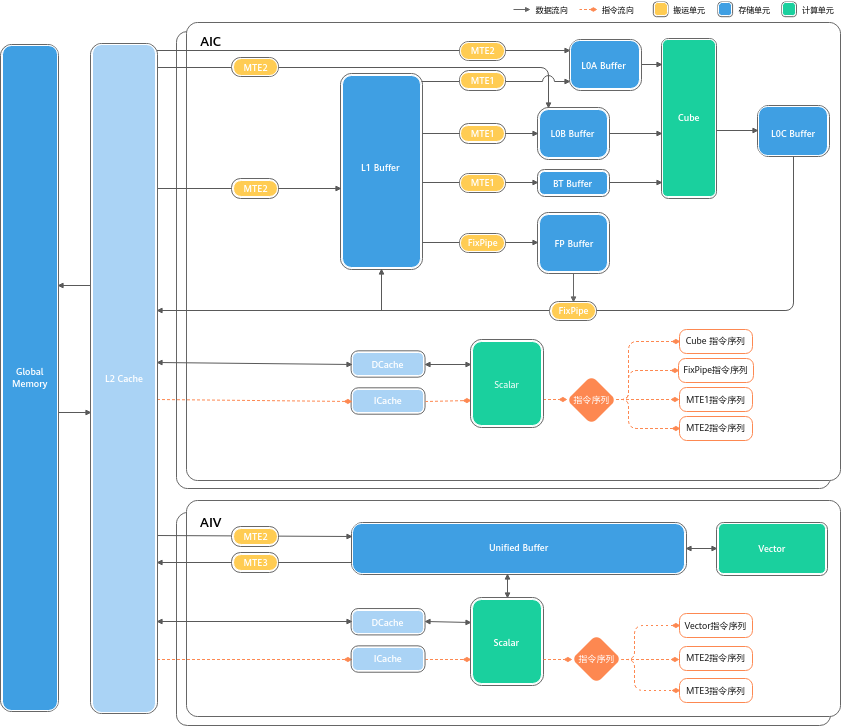
AI core负责矩阵,矢量计算,对应的,AI core包括:
- 计算单元:包括cube,vector和scalar计算单元。
- 存储单元:包括L1 Buffer、L0A Buffer、L0B Buffer、L0C Buffer、Unified Buffer、BiasTable Buffer、Fixpipe Buffer等专为高效计算设计的存储单元。这里存储单元的类型显然比GPU的要复杂很多。
- 搬运单元:包括MTE1、MTE2、MTE3和FixPipe,用于数据在不同存储单元之间的高效传输。
计算单元中,需要区分cube, vector和scalar计算单元。
- cube计算单元:负责矩阵乘法计算,每个cube计算单元一次可以处理两个fp16的16x16矩阵乘。
- vector计算单元:负责矢量计算,每个vector计算单元一次可以处理两个fp16矢量的相乘或相加。
- scalar计算单元:负责标量计算和程序的流程控制(循环,分支)
存储单元中,AI Core的主要内部存储包括:L1 Buffer(L1缓冲区),L0 Buffer(L0缓冲区),Unified Buffer(统一缓冲区)等。为了配合AI Core中的数据传输和搬运,AI Core中还包含MTE(Memory Transfer Engine,数据传递引擎)搬运单元,在搬运过程中可执行随路数据格式/类型转换。(具体作用可以参考昇腾文档)
对于cube计算单元的数据流向:
- GM →L1→L0A/L0B →Cube →L0C→FixPipe→GM
- GM →L1→L0A/L0B →Cube →L0C→FixPipe→L1
对于vector计算单元的数据流向:
- GM → UB → Vector → UB → GM
同样的,ascend编程模型的设计也依托于硬件设计,官方的介绍中,编程范式如下:
- 获取Local Memory的内存:调用AllocTensor申请内存,或者从上游队列DeQue一块内存数据。
- 完成计算或者数据搬运。
- 把上一步处理好的数据调用EnQue入队。
- 调用FreeTensor释放不再需要的内存。
但是具体到代码怎么写,ascendC支持SIMD和SIMT两种形式。SIMT的写法类似CUDA,<<<blockDim, threadDim, shareMemSize, stream>>>中的参数是完全兼容的。
cpp
__global__ void add_custom(float* x, float* y, float* z, uint64_t total_length)
{
    // Calculate global thread ID
    int32_t idx = blockIdx.x * blockDim.x + threadIdx.x;
    // Maps to the row index of output tensor
    if (idx >= total_length) {
        return;
    }
    z[idx] = x[idx] + y[idx];
}

// 通过<<<...>>>内核调用符调用算子
std::vector<float> add(std::vector<float>& x, std::vector<float>& y)
{
    ...
    // Calc splite params
    uint32_t block_num = 48;
    uint32_t thread_num_per_block = 256;
    uint32_t dyn_ubuf_size = 0;  // No need to alloc dynamic memory.
    // Call kernel funtion with <<<...>>>
    add_custom<<<block_num, thread_num_per_block, dyn_ubuf_size, stream>>>(x_device, y_device, z_device, x.size());
    ...
    return output;
}
SIMT的写法是后出现的,目的就是为了兼容cuda生态。写法上虽样,硬件资源映射上也很相似:
- blockDim再cuda上映射的是GPU上的SM,在NPU上映射的是AI Core。
- threadDim再cuda上映射的是warp,在NPU上映射的是thread。这一级就是纯粹的逻辑抽象了。
另外还有一种SIMD的写法,也是ascendC最先支持的写法:
cpp
__aicore__ inline void Process()
{
    // loop count need to be doubled, due to double buffer
    int32_t loopCount = this->tileNum * BUFFER_NUM;
    // tiling strategy, pipeline parallel
    for (int32_t i = 0; i < loopCount; i++) {
        CopyIn(i);
        Compute(i);
        CopyOut(i);
    }
}
__aicore__ inline void Compute(int32_t progress)
{
    // deque input tensors from VECIN queue
    AscendC::LocalTensor<float> xLocal = inQueueX.DeQue<float>();
    AscendC::LocalTensor<float> yLocal = inQueueY.DeQue<float>();
    AscendC::LocalTensor<float> zLocal = outQueueZ.AllocTensor<float>();
    // call Add instr for computation
    AscendC::Add(zLocal, xLocal, yLocal, this->tileLength);
    // enque the output tensor to VECOUT queue
    outQueueZ.EnQue<float>(zLocal);
    // free input tensors for reuse
    inQueueX.FreeTensor(xLocal);
    inQueueY.FreeTensor(yLocal);
}
看起来是串行的写法,但是AscendC中提供的API本质上是非阻塞的异步方法。这种写法掩盖了更多硬件特性信息。
AMD CDNA & ROCm
AMD的显卡有两种架构,在GCN架构之后,分化成了两种架构,一种是面向C端市场的RDNA,一种是面向数据中心的CDNA。简单来说,RDNA中保留了图形处理的相关单元,配合低延迟的GDDR显存;而CDNA中则专注于神经网络计算,删除了所有的图形处理单元,增加了矩阵计算核,采用了高带宽的HBM显存。
这里不会特别仔细的研究CDNA架构,仅作基础的概念学习和对比。从CDNA4的白皮书中,AMD主要强调的是他的先进封装技术。CDNA4将XCD计算芯片垂直堆叠在IOD芯片上,
ROCm(Radeon Open Compute),简单理解就是AMD上的“CUDA生态”。在AMD GPU环境的pytorch中,使用torch.cuda.is_available()返回的是True。
AMD的路线是完全兼容cuda,它并没有实现自己的一套开发语言,而是沿用了cuda的编程模型。使用HIP层做转换,但是就会面临和硬件特性相关的PTX汇编,是无法完全达到NVIDIA GPU的性能,只能人工优化。所以一些场景下,如pytorch,AMD的性能会低于NVIDIA GPU。
寒武纪 思元
寒武纪的芯片架构叫 MLUarch,Machine Learning Unit Architecture。
一个 MLU 设备由 Memory 子系统、MTP (Multi Tensor Processor)子系统、Media 子系统等构成。 MTP 子系统是寒武纪 MLU 架构的核心。
指南中对比了MLU和NVIDIA GPU的术语:
| MLU | GPU | 描述 |
|---|---|---|
| L2 Cache | L2 Cache | MLU上或称为LLC(Last Level Cache),L2 Cache为Device级多Cluster共享 |
| Cambricon BANG Kernel | Kernel | 一个Host端发射到Device上并行执行的函数,GPU/MLU和CPU的函数执行是并行独立的 |
| Global-DRAM | Global Memory | 指片外DDR或HBM内存,多Task或Thread共享的地址空间 |
| Local-DRAM | Local Memory(或Private Memory) | 指片外或映射到Cache上的高速私有内存,并行编程中的空间作用域是Task/Thread内私有的局部 |
MTP 架构中,MTP Cluster 是由多个 IPU Core 和 一块共享 SRAM (或称为Shared-RAM)组成,是 MTP 架构中的最小执行单元。 当 TP 架构的架构编号和 MTP 架构的编号相同时,MTP 架构的硬件可以二进制兼容地执行 TP 架构开发和编译的程序。
MTP 可以类比 GPU 的一个 GPC (GPU Processing Cluster)或 SE (Shader Engine),从 Cluster 级架构对比和 GPU 的术语见下表:
| MLU | GPU | 描述 |
|---|---|---|
| 无 | L1 Cache | GPU的L1 Cache是SM或SE内共享,SM的L1 DCache和SharedMemory在GPU架构共享并可调大小,SE内的L1 Cache在GPU架构中可以多CU共享,MTP内的Shared-RAM具备多IPU共享L1 DCache的作用 |
| MTP(多TP并行) | GPC/SE(多SM/CU并行) | N/A |
| Shared-RAM | Shared Memory(或Local Data Share) | Cluster内作为多Task/Thread共享的存储层次,在并行编程的通讯和归约时可极大避免片外访存延迟,充分利用片上带宽和数据局部性降低功耗 |
| Union Task | Thread Block(或Workgroup) | 软件联合多个独立线程的概念,多个Task/Thread在Kernel中同时执行,并行的Task/Thread之间可以同步通讯 |
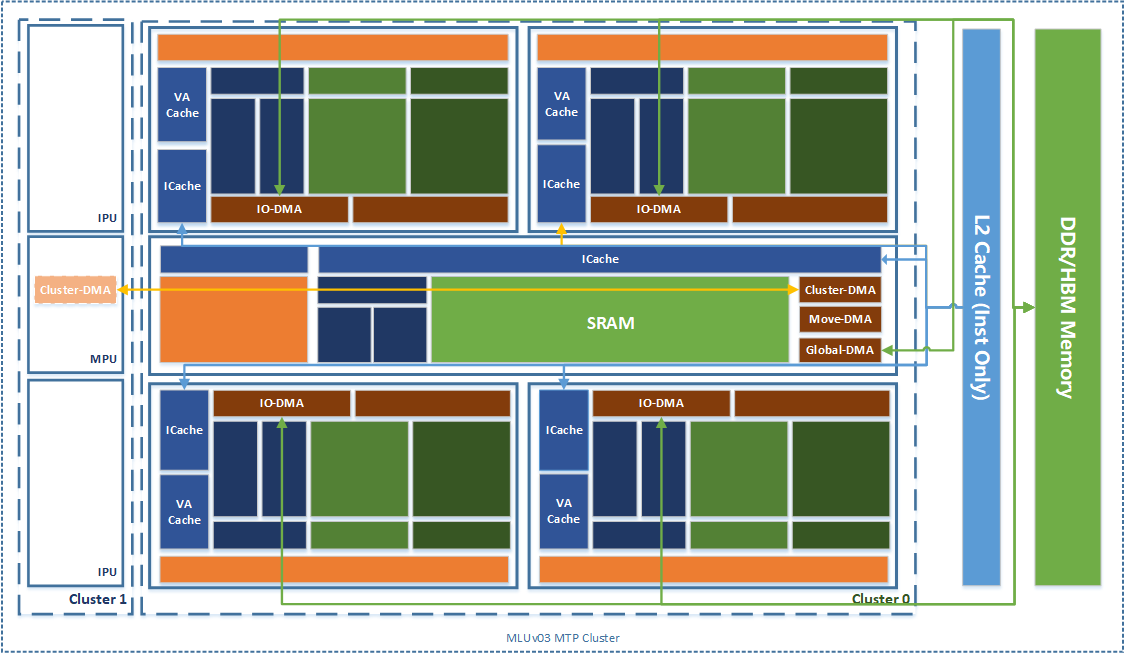
MLUv03的MTP由 4 个 IPU 和 1 个 MPU 组成。不同 MTP 型号的 SRAM 存储大小不一样。参考图: